Xcena MX1: 2TB CXL Memory and 1,000+ RISC-V Cores 30 October 2026·3967 words·19 mins Xcena MX1 CXL Computational Memory RISC-V Ai Infrastructure Memory Expansion Near-Memory Computing Llm Inference Data Center Architecture
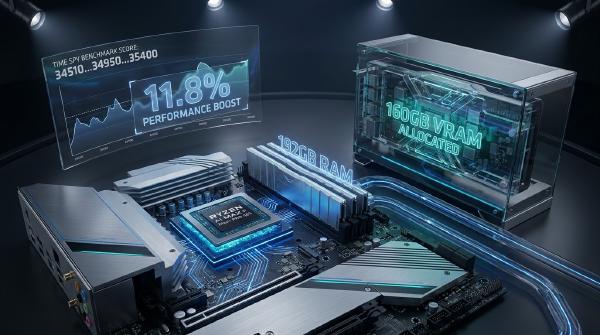
Ryzen AI Max+ PRO 495: 12% Faster, More AI Memory 12 October 2026·2721 words·13 mins AMD Ryzen AI Max+ PRO 495 AMD Gorgon Halo Ryzen AI Max+ 395 Mini PCs Local AI Llm Inference Integrated-Graphics Hardware Benchmarks
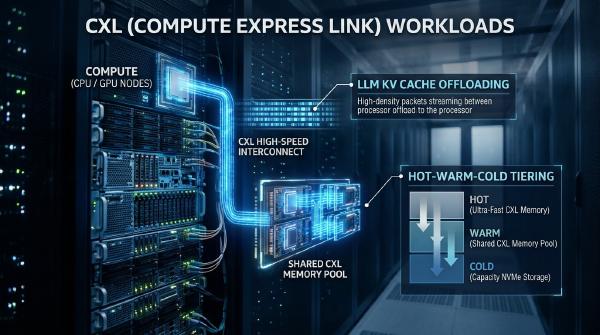
CXL Workloads: KV Cache, Memory Pooling, and Tiering 10 October 2026·3610 words·18 mins CXL Memory Tiering Llm Inference KV Cache Memory Pooling NUMA Linux Kernel Data Center Architecture
Cerebras CS-4, CS-5 and CS-6: Wafer-Scale AI Roadmap 27 August 2026·1652 words·8 mins Cerebras CS-4 CS-5 CS-6 Wafer-Scale Computing AI Accelerators Llm Inference Ai Infrastructure AI Hardware
FreeToken Lets a Single RTX 5090 Run 284B MoE Models Locally 22 August 2026·2215 words·11 mins FreeToken Llm Inference MoE Edge AI RTX 5090 Local AI AI Agents GPU Computing PCIe
M4 Max Mac Studio Beats GB10 and Strix Halo in Local AI 31 July 2026·1147 words·6 mins Apple M4 Max MAC Studio Local AI Llm Inference NVIDIA GB10 AMD Strix Halo AI Workstation Unified Memory
NVIDIA and ETH Zurich Push Multi-GPU Communication Latency Toward the Speed of Light 21 July 2026·1630 words·8 mins Nvidia GPU Computing Llm Inference NVLink High Performance Computing CUDA Distributed Systems Ai Infrastructure
AMD Ryzen AI Halo Launch: A DGX Spark Challenger for Local AI 15 June 2026·688 words·4 mins Amd Ryzen Ai AI PC Local Inference DGX Spark Strix Halo Rocm AI Hardware Llm Inference
D-Matrix Targets Fast AI Tokens With 3D Memory and Ultra-Low-Latency NICs 7 February 2026·939 words·5 mins AI Accelerators Llm Inference Data Centers Memory Architecture Networking